;)
;)
;)




GPU·CPU 서버 옆에 대용량 메모리 랙 두는 방식
멀티턴 에이전트 실험에서 응답 시간 개선 확인
멀티턴 에이전트 실험에서 응답 시간 개선 확인
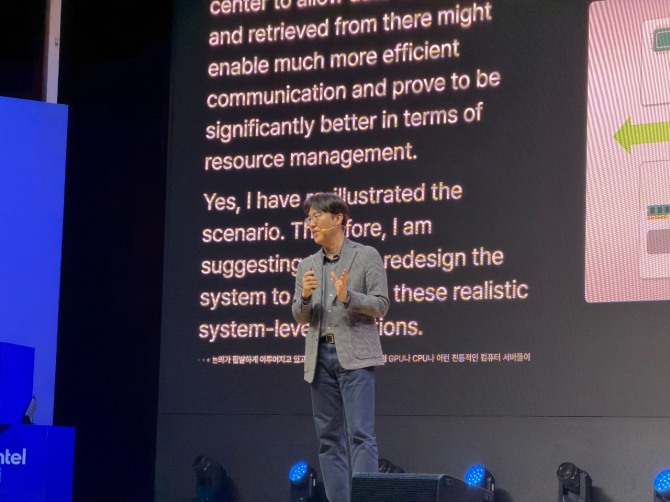 이미지 확대보기
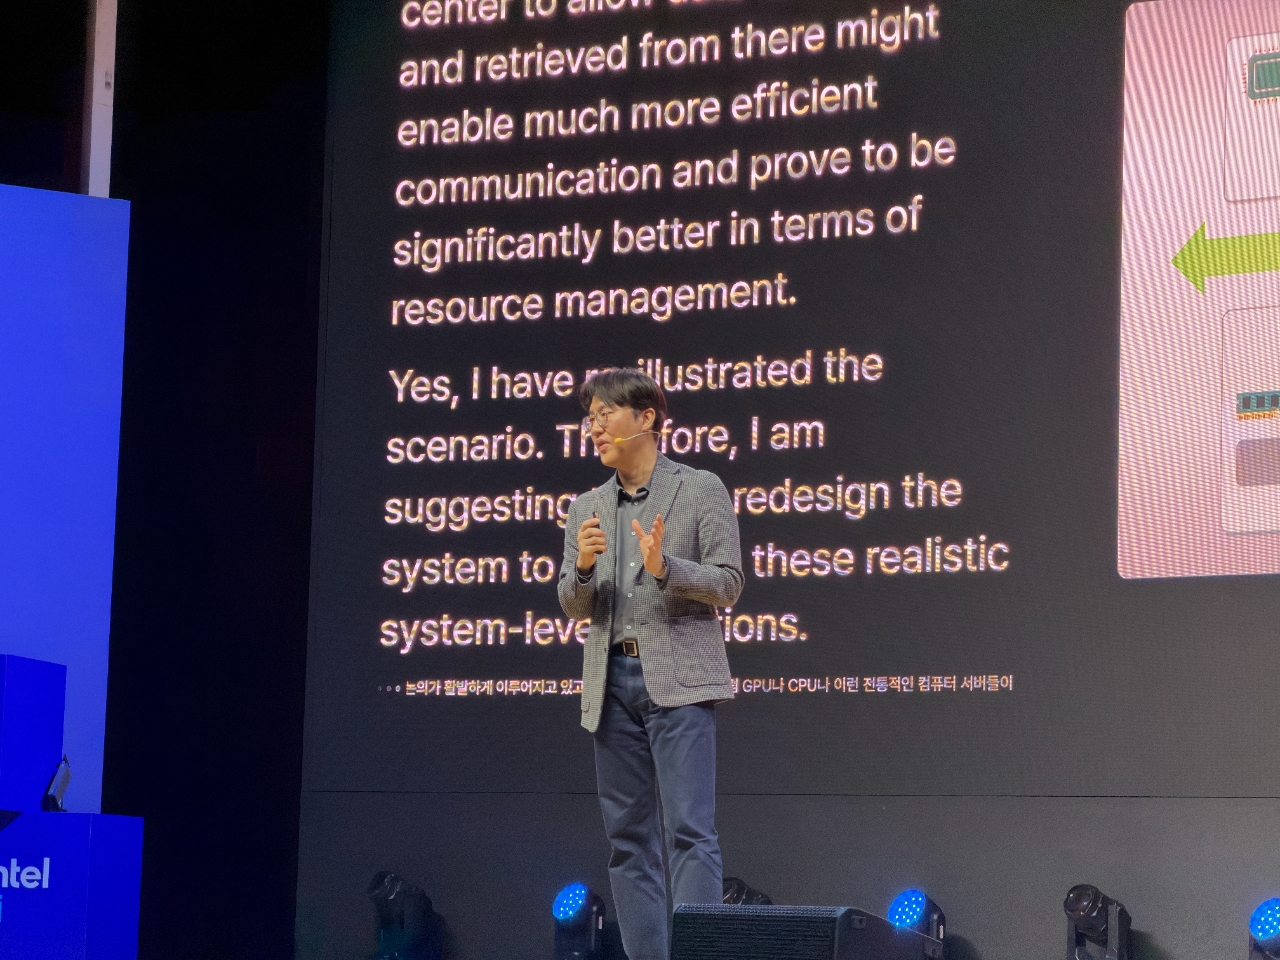
SK하이닉스가 AI 에이전트(스스로 작업을 수행하는 AI) 시대에는 메모리 부담이 더 커질 것이라며, 서버 옆에 대용량 메모리를 따로 두고 함께 쓰는 새로운 시스템 구조를 제안했다.
주영표 SK하이닉스 부사장은 12일 서울 코엑스에서 열린 '인텔 AI 서밋 서울 2026' 파트너 세션에서 "에이전트 AI 시대에 메모리 용량과 성능에 대한 압박이 완화될지 강화될지 고민해야 하는데, 우리는 강화될 것으로 보고 있다"고 말했다.
주 부사장은 기존 세대 AI 모델의 매개변수를 저장하는 데만 3테라바이트(TB) 이상의 메모리가 필요하다고 설명했다. 스마트폰 200대 이상의 메모리를 모아야 하는 규모다. 사용자가 답을 빠르게 받으려면 초당 4TB가량의 데이터를 읽어야 하는데, 스마트폰 300대 분량의 D램 데이터를 매초 읽어내는 수준이다. 그는 코딩 에이전트나 여러 에이전트가 서로 통신하며 일하는 환경에서는 사람이 기다리는 시간을 줄여야 하는 만큼 성능 요구가 한층 높아진다고 덧붙였다.
그가 내놓은 해법은 GPU 서버 랙과 CPU 서버 랙 옆에 대용량 메모리 랙을 두고 함께 쓰는 구조다. 집마다 차를 여러 대 두는 대신 한 대씩만 두고 필요할 때 공유 차량을 이용하는 것과 같다는 비유도 들었다. 메모리 활용 효율이 높아지고 응답 시간과 데이터 관리 부담도 줄어든다는 설명이다.
SK하이닉스는 파트너사와 함께 실험도 진행했다. 대화가 길어질수록 AI가 이전 문맥을 저장하는 임시 메모리(KV 캐시)가 급증하고, 공간이 모자라면 계산을 처음부터 다시 해야 한다. 이 KV 캐시를 메모리 랙에 저장해 두고 꺼내 쓰자 평균 응답 시간과 최악 구간의 지연이 모두 개선됐다는 것이다.
주 부사장은 “SK하이닉스는 풀스택 AI 메모리 크리에이터로서 아키텍처 단계부터 고객·파트너와 함께 논의하고 있다”며 "인텔과도 협력하고 있다"고 밝혔다.
유덕규 글로벌이코노믹 기자 udeok@g-enews.com