;)
;)
;)




하버드·아시아소사이어티 연구진 분석… 美 의회 '데이터 자본화' 권고에 "실패한 과거 모델" 반박
中, 60개 데이터 거래소 열고 대차대조표 등재했으나… '가격 책정 불능·장부 부풀리기' 한계 봉착
"데이터 가치는 사후 사용 사례가 결정"… 팰런티어식 현장 엔지니어 모델 및 공유 인프라로 전환
中, 60개 데이터 거래소 열고 대차대조표 등재했으나… '가격 책정 불능·장부 부풀리기' 한계 봉착
"데이터 가치는 사후 사용 사례가 결정"… 팰런티어식 현장 엔지니어 모델 및 공유 인프라로 전환
 이미지 확대보기
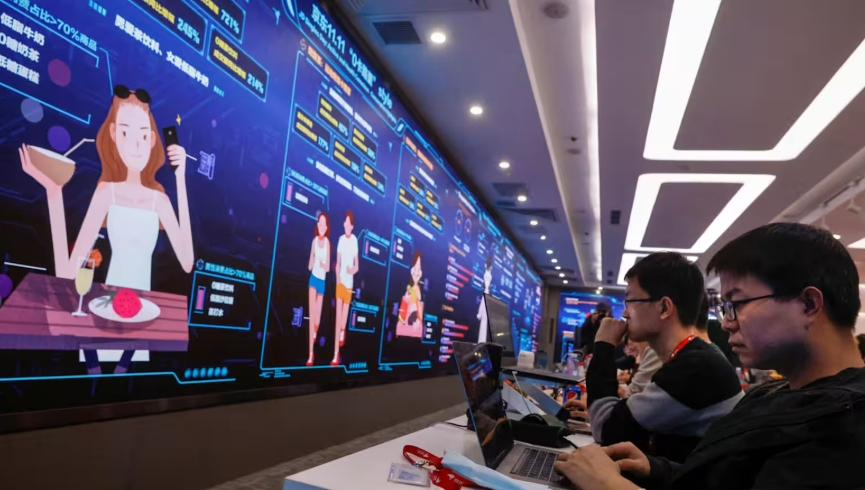
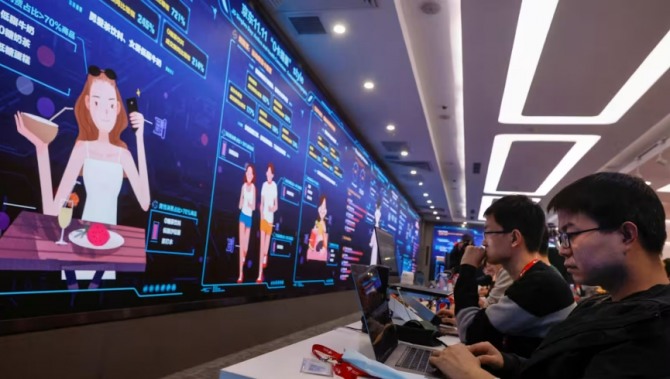
미국 의회와 정책 입안자들이 인공지능(AI) 패권 경쟁에서 앞서나가기 위해 중국식 '데이터 자본화' 정책을 벤치마킹하려는 움직임을 보이는 가운데, 정작 중국 현지에서는 데이터를 물리적 자산처럼 사고파는 '사전적 자산화' 모델이 참담한 실패로 끝나고 전면적인 전략 수정에 들어갔다는 전문가들의 엄중한 경고가 나왔다.
미·중 경제안보검토위원회(USCC) 등 워싱턴 조야는 최근 중국이 데이터를 기업 대차대조표의 자산으로 등재하고 국영 거래소를 통해 거래하는 '데이터 중화인민공화국' 시스템을 구축해 앞서가고 있다며 미국도 이를 제도화해야 한다고 권고했다.
연구진은 미국이 AI 시대를 맞아 데이터 전략을 수립하되, 중국이 이미 버리고 있는 '형식적 자산화'를 답습할 것이 아니라 구체적 비즈니스 문제와 직결되는 ‘활용성(Usability)’과 ‘공유 인프라’ 구축에 집중해야 한다고 강조했다.
9월 17일(현지시각) 일본 종합 경제 미디어 닛케이 아시아(Nikkei Asia)에 게재된 란 궈(하버드 로스쿨·아시아소사이어티 정책연구소)와 리지 C. 리(CCA 펠로우)의 심층 분석에 따르면, 워싱턴이 주목하는 중국식 데이터 거래소 모델은 현실의 벽에 부딪혀 근본적 전환기를 맞고 있다.
"석유와 달리 사전에 값 못 매겨"… 60개 데이터 거래소의 적자 수렁
중국 정부는 지난 2022년 '데이터 20조' 정책을 발표하며 데이터를 토지, 자본, 노동에 이은 제5대 생산 요소로 선언하고 자산화, 국영 거래소, 공공 데이터 개방의 3대 축을 강력히 추진했다.
이에 따라 각 지방정부는 경쟁적으로 60개 이상의 데이터 거래소를 열었고, 기업들은 데이터를 지식재산권이나 부동산처럼 회계 장부에 자산으로 계상하도록 장려받았다.
그러나 이 시도는 구조적 한계에 부딪혔다.
원유나 부동산처럼 시장에서 비교 가능한 표준 가격을 매길 수 있는 자산과 달리, 데이터의 가치는 '누가 어떤 목적으로 사용하는가'에 따라 극단적으로 갈리기 때문이다.
가령 특정 분자 결합 데이터는 해당 신약 타깃을 연구하는 제약사에만 천문학적 가치를 지닐 뿐, 다른 기업에는 무가치하다.
구체적인 실제 활용처(사용 사례)가 없는 상태에서 매겨지는 데이터 가격은 허구에 불과했고, 결국 데이터 자산화는 국유기업(SOE)들이 대차대조표를 인위적으로 부풀려 은행 대출 한도를 늘리는 회계적 편법 수단으로 변질됐다.
거래소 역시 전문 지식 부족으로 유명무실해져 대부분의 실거래는 거래소 밖에서 장외로 이뤄졌고, 대다수 거래소는 만성 적자에 허덕이다 올해 초 신설이 전면 금지됐다.
'3대 이질성' 극복 난제… '데이터 자산'에서 'AI용 데이터·시나리오'로
중국 실무자들은 데이터 거버넌스의 본질적 난제로 ‘소유자, 데이터 구조·형식, 저장 도메인’이 제각기 다른 ‘세 가지 이질성(Three Heterogeneities)’을 꼽는다.
이를 누군가 직접 정제, 표준화, 연결해 실제 기업 워크플로우에 녹여내지 않으면 데이터는 한 줄의 코드나 쓰레기에 불과하다는 설명이다.
이에 따라 올해 베이징과 상하이의 데이터·AI 콘퍼런스에서는 '데이터 자산'이라는 용어 대신 '디지털 인텔리전스', 'AI를 위한 데이터', '시나리오 기반 관리(Scenario-based management)'가 핵심 화두로 부상했다.
무작정 데이터를 모아두는 것이 아니라, 구체적인 산업 수요와 현장 문제에서 출발해 역으로 필요한 고품질 데이터를 찾아내는 방식이다.
실제로 중국 국가데이터국(NDA)은 지난 6월 11개 산업 분야에서 760개의 세부 응용 시나리오 가이드라인을 발표하며, 명확한 목적 없는 맹목적 데이터셋 구축에 대해 공식 경고를 발령했다.
이러한 전략 변화 속에서 중국이 가장 주목하는 벤치마킹 대상은 역설적으로 미국의 빅데이터 유니콘 팰런티어(Palantir)다.
고객사의 비즈니스 현장에 엔지니어를 직접 파견해 복잡한 비즈니스 문제를 데이터 파이프라인으로 전환해 주는 팰런티어의 '전진 배치 엔지니어(FDE)' 모델이야말로 데이터에 실질적 생명력을 불어넣는 해법으로 평가받고 있다.
"미국, 중국의 실패 답습 말아야"… 공유 인프라와 표준화가 핵심
중국 내에서 고사 위기에 처한 데이터 거래소들도 역할을 180도 바꾸고 있다.
표준화된 데이터 단위를 사고파는 시장(마켓플레이스)을 포기하고, 데이터셋의 잠재 수요자를 연결하고 기업들이 보안을 유지하며 공동 분석을 수행할 수 있는 ‘신뢰할 수 있는 데이터 공간(Trusted Data Space)’ 등 인프라 제공자로 성격을 재정의하고 있다.
저자들은 이번 중국의 정책적 시행착오가 미국에 중대한 시사점을 던진다고 강조했다.
미국이 AI 시대를 선도하기 위한 국가 차원의 데이터 전략을 수립해야 하는 것은 분명하지만, 중국이 이미 폐기 수순을 밟고 있는 '데이터의 강제 자본화'나 '거래소 설립'을 따라 하는 것은 실패를 재현하는 패착이 될 것이라는 경고다.
진정한 AI 시대의 국가 경쟁력은 장부상의 자산 평가액이 아니라, 조직 내에 흩어진 데이터 사일로(장벽)를 허물고 실제 AI 모델이 학습·추론에 바로 활용할 수 있도록 데이터를 정제, 표준화, 공유하기 쉽게 만드는 ‘화려하지 않은 기초 거버넌스 작업’에 달려 있다는 지적이다.
중국의 데이터 전략 급선회와 미국을 향한 제언은, 향후 ‘데이터를 단순한 투기적 자산으로 바라보던 초기 환상에서 벗어나 실제 현장의 구체적 비즈니스 문제와 결합하는 실용적 AI 파이프라인 구축이 국가 데이터 패권의 본질임을 일깨운 사건’인 동시에 ‘미·중 기술 냉전 속에서 상대국의 외형적 정책을 무비판적으로 추종하기보다 물리적 데이터 품질과 상호운용성이라는 기초 체력을 다지는 국가가 최종 승기를 잡을 것임을 보여주는 중요한 이정표’로 작용할 전망이다.
신경원 글로벌이코노믹 기자 shincm@g-enews.com